 ドキュメント
テキスト音声変換_TTS システムの実装
実験の目的
- テキスト音声変換(TTS)システムを理解します。2. テキストを中国語・英語など複数の言語の音声に変換できるようにします。
活用シーン
音声アシスタント、オーディオブックの生成、リアルタイム音声アナウンスなど、高品質な音声出力が求められる用途に利用できます。
機能要件
テキストを中国語・英語など複数の言語の音声として出力します。
ハードウェアの準備
| No. | 名称 | 数量 | 備考 |
|---|---|---|---|
| 1 | RDK X5 | 1 | 組み込みメインボード(32GB メモリーカード付き)。上位機システムを実行します |
| 2 | カードリーダー | 1 | イメージシステムの書き込みに使用します |
| 3 | イヤホン | 1 | 音声出力(左/右チャンネル)+マイク入力に対応したもの |
| 4 | 電源ケーブル | 1 | 給電用 |
| 5 | LAN ケーブル | 1 | ネットワーク接続用 |
| 6 | ディスプレイ(各自で用意) | 1 | 操作用 |
| 7 | Bluetooth キーボード・マウス(各自で用意) | 1 | メインボードの操作用 |
回路接続
ハードウェアモジュール
ヒント:ハードウェアモジュールの使用説明
1.1 ハードウェアインターフェース で RDK X5 のインターフェースをすぐに把握できます
オンボード Earphone オーディオ端子 で録音・再生機能について確認できます
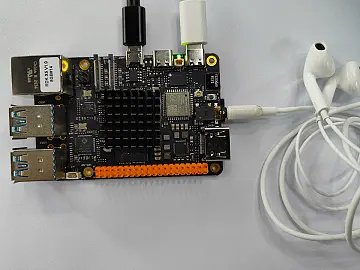
実機の配線
下図を参考に接続し、その後ディスプレイ、キーボード・マウスを接続します(またはリモートアクセスを行います)。
ソフトウェア設計
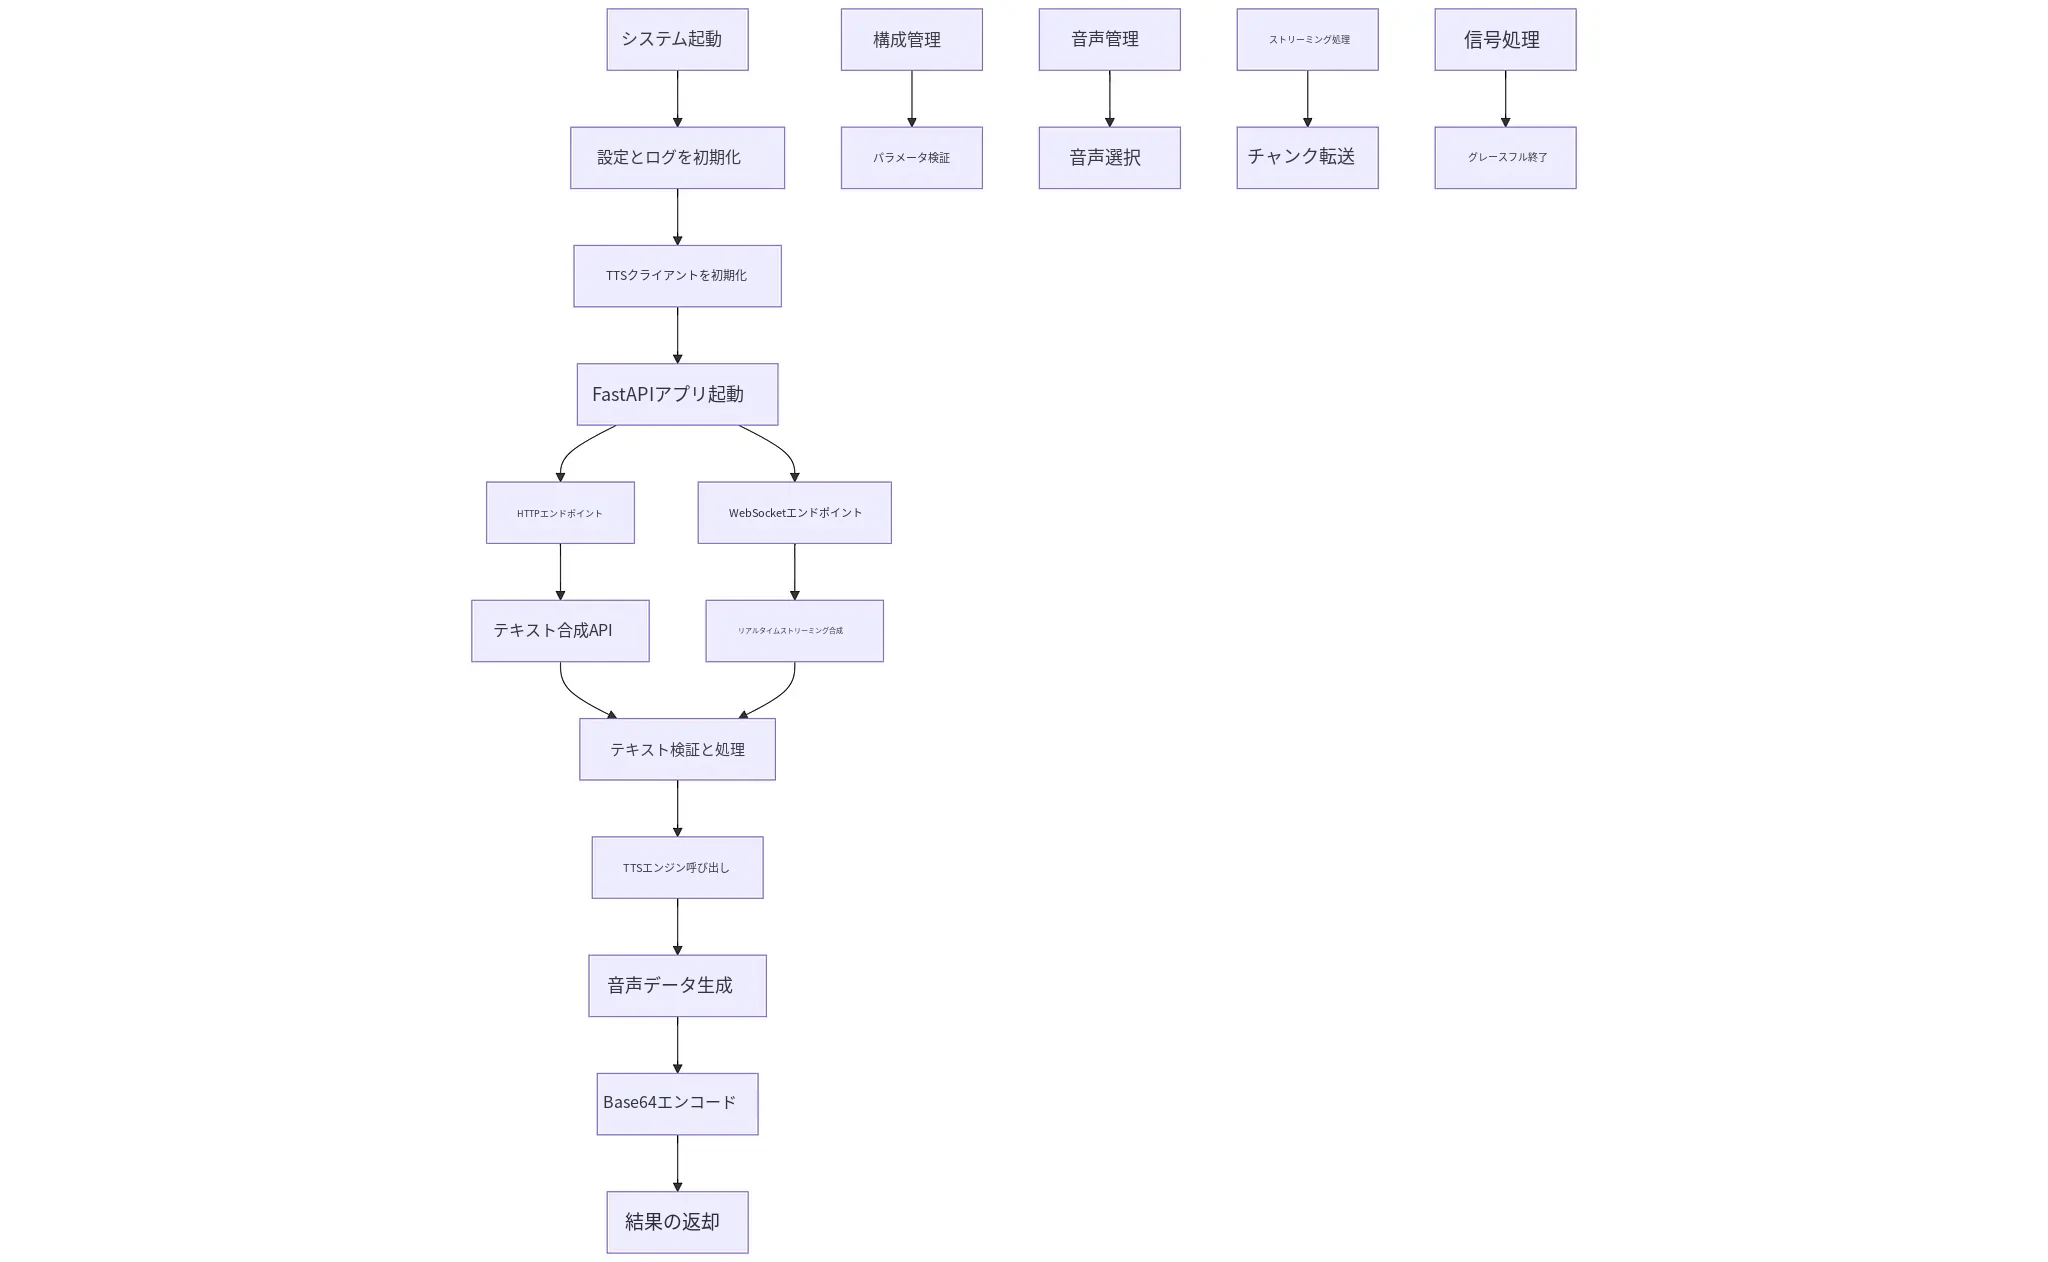
設計フローチャート
ソースコードのダウンロード
ソースファイル:tts.rar
ソースコードのリンク:(HumansX サポートより提供)
プログラムコード
コードの関係:
| ファイル/モジュール | 機能説明 |
|---|---|
| main.py | メインプログラム。FastAPI ベースのテキスト音声変換サービスで、WebSocket によるリアルタイムのストリーミング合成に対応 |
| tts/client.py | TTS クライアント。火山引擎、Azure TTS などの下位 TTS エンジンを含みます |
具体的なコード:
プロジェクトの完全なコードは(ソースファイル)をクリックしてダウンロードしてください。
#!/usr/bin/env python3
"""
TTS独立应用主服务器
基于FastAPI的文本转语音服务,支持WebSocket实时流式合成
"""

import asyncio
import logging
import signal
import sys
import json
import base64
from contextlib import asynccontextmanager
from pathlib import Path
from typing import Optional, Dict, Any
from datetime import datetime

import uvicorn
from fastapi import FastAPI, WebSocket, WebSocketDisconnect, HTTPException
from fastapi.responses import JSONResponse, FileResponse
from fastapi.middleware.cors import CORSMiddleware
from fastapi.staticfiles import StaticFiles
from pydantic import BaseModel

# 添加项目根目录到Python路径
sys.path.insert(0, str(Path(__file__).parent))

# 尝试导入python-dotenv,如果没有安装则跳过
try:
    from dotenv import load_dotenv
    load_dotenv()
    print("已加载 .env 文件")
except ImportError:
    print("python-dotenv 未安装,跳过 .env 文件加载")

from config import get_config, AppConfig
from tts.client import TTSClient, TTSConfig

# 全局变量
tts_client: Optional[TTSClient] = None
app_config: Optional[AppConfig] = None
active_connections: set = set()

# 初始化配置和日志
def init_logging_and_config():
    global app_config
    app_config = get_config()

    # 配置日志
    logging.basicConfig(
        level=getattr(logging, app_config.logging.level),
        format=app_config.logging.format
    )

    # 调试信息
    logger = logging.getLogger("TTS_MAIN")
    logger.info(f"配置加载完成:")
    logger.info(f"  APP ID: {app_config.tts.app_id[:5]}...{app_config.tts.app_id[-5:] if app_config.tts.app_id else 'None'}")
    logger.info(f"  Resource ID: {app_config.tts.resource_id}")
    logger.info(f"  默认音色: {app_config.tts.default_speaker}")

init_logging_and_config()
logger = logging.getLogger("TTS_MAIN")

@asynccontextmanager
async def lifespan(app: FastAPI):
    """应用生命周期管理"""
    global tts_client, app_config

    logger.info("启动TTS独立应用...")

    try:
        # 初始化TTS客户端配置
        tts_config = TTSConfig(
            app_id=app_config.tts.app_id,
            access_token=app_config.tts.access_token,
            resource_id=app_config.tts.resource_id,
            ws_url=app_config.tts.ws_url,
            default_speaker=app_config.tts.default_speaker,
            format=app_config.tts.format,
            sample_rate=app_config.tts.sample_rate,
            enable_timestamp=app_config.tts.enable_timestamp,
            speech_rate=app_config.tts.speech_rate,
            loudness_rate=app_config.tts.loudness_rate,
            emotion=app_config.tts.emotion,
            emotion_scale=app_config.tts.emotion_scale,
            disable_markdown_filter=app_config.tts.disable_markdown_filter,
            disable_emoji_filter=app_config.tts.disable_emoji_filter,
            enable_language_detector=app_config.tts.enable_language_detector,
            silence_duration=app_config.tts.silence_duration,
            explicit_language=app_config.tts.explicit_language
        )

        # 初始化TTS客户端
        tts_client = TTSClient(tts_config)
        logger.info("TTS客户端初始化完成")

        yield

    except Exception as e:
        logger.error(f"应用启动失败: {e}", exc_info=True)
        raise
    finally:
        # 清理资源
        logger.info("正在关闭TTS应用...")
        if tts_client:
            try:
                await tts_client.close()
            except Exception as e:
                logger.error(f"关闭TTS客户端时出错: {e}")
        logger.info("TTS应用已关闭")

# 创建FastAPI应用
app = FastAPI(
    title="TTS独立应用",
    description="文本转语音服务,支持多种音色和格式",
    version="1.0.0",
    lifespan=lifespan
)

# 添加CORS中间件
if app_config.frontend.enable_cors:
    app.add_middleware(
        CORSMiddleware,
        allow_origins=app_config.frontend.allowed_origins,
        allow_credentials=True,
        allow_methods=["*"],
        allow_headers=["*"],
    )

# 挂载静态文件
static_dir = Path(app_config.frontend.static_files)
if static_dir.exists():
    app.mount("/static", StaticFiles(directory=str(static_dir)), name="static")

# 请求/响应模型
class SynthesizeRequest(BaseModel):
    text: str
    voice: Optional[str] = None
    speed: Optional[float] = None
    volume: Optional[float] = None
    format: Optional[str] = None

class SynthesizeResponse(BaseModel):
    audio_data: str  # Base64编码的音频数据
    format: str
    duration: Optional[float] = None

async def broadcast_message(message: dict):
    """广播消息到所有WebSocket连接"""
    global active_connections
    if not active_connections:
        return

    message_text = json.dumps(message, ensure_ascii=False)
    disconnected = set()

    for websocket in active_connections.copy():
        try:
            await websocket.send_text(message_text)
        except Exception:
            disconnected.add(websocket)

    # 清理断开的连接
    active_connections -= disconnected

@app.get("/")
async def root():
    """主页面 - 返回静态HTML文件"""
    index_file = static_dir / "index.html"
    if index_file.exists():
        return FileResponse(str(index_file))
    return {"message": "TTS服务已启动"}

@app.get("/health")
async def health_check():
    """健康检查"""
    global tts_client

    status = {
        "status": "healthy",
        "tts_client": tts_client is not None,
        "config_loaded": app_config is not None
    }

    if not all(status.values()):
        status["status"] = "unhealthy"
        return JSONResponse(status_code=503, content=status)

    return status

@app.get("/config")
async def get_config_info():
    """获取配置信息"""
    global app_config

    if not app_config:
        raise HTTPException(status_code=500, detail="配置未加载")

    # 将VoiceGroup和VoiceOption对象转换为字典
    voices_data = []
    for voice_group in app_config.tts.voices:
        group_data = {
            "group": voice_group.group,
            "options": [
                {
                    "id": option.id,
                    "name": option.name,
                    "languages": option.languages
                }
                for option in voice_group.options
            ]
        }
        voices_data.append(group_data)

    return {
        "default_voice": app_config.tts.default_speaker,
        "voices": voices_data,  # 转换后的音色列表
        "supported_formats": ["mp3", "wav", "flac"],
        "max_text_length": app_config.security.max_text_length,
        "audio_processing": app_config.audio_processing.enable_enhancement
    }

@app.post("/synthesize", response_model=SynthesizeResponse)
async def synthesize_endpoint(request: SynthesizeRequest):
    """文本转语音接口"""
    global tts_client

    if not tts_client:
        raise HTTPException(status_code=500, detail="TTS客户端未初始化")

    # 验证文本长度
    if len(request.text) > app_config.security.max_text_length:
        raise HTTPException(
            status_code=400,
            detail=f"文本长度超过限制 ({app_config.security.max_text_length} 字符)"
        )

    try:
        # 合成音频
        audio_data = await tts_client.synthesize_text(
            text=request.text,
            speaker=request.voice
        )

        # 转换为Base64
        audio_base64 = base64.b64encode(audio_data).decode('utf-8')

        return SynthesizeResponse(
            audio_data=audio_base64,
            format=request.format or app_config.tts.format
        )

    except Exception as e:
        logger.error(f"语音合成失败: {e}", exc_info=True)
        raise HTTPException(status_code=500, detail=str(e))

@app.websocket("/ws")
async def websocket_endpoint(websocket: WebSocket):
    """WebSocket端点,用于实时流式语音合成"""
    global active_connections, tts_client

    await websocket.accept()
    active_connections.add(websocket)
    logger.info(f"WebSocket连接已建立,当前连接数: {len(active_connections)}")

    try:
        while True:
            # 接收客户端消息
            data = await websocket.receive_text()
            message_data = json.loads(data)

            # 解析请求参数
            message_type = message_data.get('type', 'synthesize')

            # 处理心跳ping
            if message_type == 'ping':
                await websocket.send_text(json.dumps({
                    "type": "pong",
                    "timestamp": message_data.get('timestamp', '')
                }, ensure_ascii=False))
                continue

            text = message_data.get('text', '')
            voice = message_data.get('voice')
            speed = message_data.get('speed')
            volume = message_data.get('volume')
            format = message_data.get('format')

            if not text:
                await websocket.send_text(json.dumps({
                    "type": "synthesis_error",
                    "error": "文本不能为空"
                }, ensure_ascii=False))
                continue

            # 验证文本长度
            if len(text) > app_config.security.max_text_length:
                await websocket.send_text(json.dumps({
                    "type": "synthesis_error",
                    "error": f"文本长度超过限制 ({app_config.security.max_text_length} 字符)"
                }, ensure_ascii=False))
                continue

            logger.info(f"语音合成请求: {text[:50]}...")

            try:
                # 临时调整参数(如果提供了)
                original_config = None
                if any([voice, speed, volume, format]):
                    original_config = {
                        'default_speaker': tts_client.config.default_speaker,
                        'speech_rate': tts_client.config.speech_rate,
                        'loudness_rate': tts_client.config.loudness_rate,
                        'format': tts_client.config.format
                    }

                    if voice:
                        tts_client.config.default_speaker = voice
                    if speed is not None:
                        # 使用官方范围 [0.2, 3.0],直接传递给火山引擎
                        tts_client.config.speech_rate = max(0.2, min(3.0, float(speed)))
                    if volume is not None:
                        # 使用官方范围 [0.1, 3.0],直接传递给火山引擎
                        tts_client.config.loudness_rate = max(0.1, min(3.0, float(volume)))
                    if format:
                        tts_client.config.format = format

                # 流式合成
                audio_chunks = []
                total_bytes = 0
                start_time = datetime.now()

                async for chunk in tts_client.synthesize_stream(text, voice):
                    audio_chunks.append(chunk)
                    total_bytes += len(chunk)

                    # 发送进度更新(每接收10个块)
                    if len(audio_chunks) % 10 == 0:
                        await websocket.send_text(json.dumps({
                            "type": "synthesis_progress",
                            "progress": min(95, len(audio_chunks) // 2)  # 简单进度模拟
                        }, ensure_ascii=False))

                # 合成完成
                end_time = datetime.now()
                duration = (end_time - start_time).total_seconds()

                # 合并音频数据
                full_audio = b''.join(audio_chunks)

                # 检查是否有音频数据返回
                if len(full_audio) == 0:
                    await websocket.send_text(json.dumps({
                        "type": "synthesis_error",
                        "error": "语音合成失败:未生成音频数据。可能是所选音色不支持当前文本语言,请选择合适的音色重试。"
                    }, ensure_ascii=False))
                    logger.warning(f"语音合成失败:未生成音频数据。文本: {text[:50]}..., 音色: {voice}")
                    return

                # 转换为Base64
                audio_base64 = base64.b64encode(full_audio).decode('utf-8')

                await websocket.send_text(json.dumps({
                    "type": "synthesis_complete",
                    "audio_data": audio_base64,
                    "format": format or app_config.tts.format,
                    "duration": duration,
                    "size": len(full_audio)
                }, ensure_ascii=False))

                logger.info(f"语音合成完成: {len(full_audio)} 字节, 耗时: {duration:.2f}秒")

                # 恢复原始配置
                if original_config:
                    tts_client.config.default_speaker = original_config['default_speaker']
                    tts_client.config.speech_rate = original_config['speech_rate']
                    tts_client.config.loudness_rate = original_config['loudness_rate']
                    tts_client.config.format = original_config['format']

            except Exception as e:
                logger.error(f"语音合成失败: {e}", exc_info=True)
                await websocket.send_text(json.dumps({
                    "type": "synthesis_error",
                    "error": str(e)
                }, ensure_ascii=False))

    except WebSocketDisconnect:
        logger.info("WebSocket客户端断开连接")
    except Exception as e:
        logger.error(f"WebSocket错误: {e}", exc_info=True)
    finally:
        active_connections.discard(websocket)
        logger.info(f"WebSocket连接已断开,当前连接数: {len(active_connections)}")

def signal_handler(signum, frame):
    """信号处理器"""
    logger.info(f"收到信号 {signum},正在关闭应用...")
    sys.exit(0)

def main():
    """主函数"""
    global app_config

    # 设置信号处理器
    signal.signal(signal.SIGINT, signal_handler)
    signal.signal(signal.SIGTERM, signal_handler)

    # 启动服务器
    uvicorn.run(
        "main:app",
        host=app_config.server.host,
        port=app_config.server.port,
        reload=app_config.server.debug,
        log_level=app_config.logging.level.lower()
    )

if __name__ == "__main__":
    main()
操作手順
回路接続が完了したら、ターミナルにリモートアクセスします:
- ターミナルにリモートアクセスします。ターミナルで次のコマンドを入力して Enter キーを押します
ssh sunrise@192.168.8.111
パスワードは sunrise です。パスワードを入力して Enter キーを押すとログインが完了します。
- サービスを起動します。tts フォルダに移動し、メインプログラム main.py を起動します。
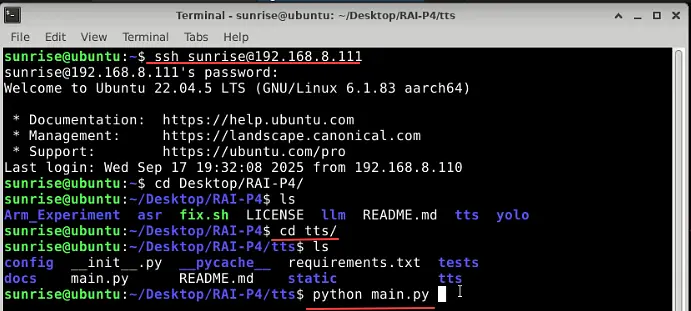
Enter キーを押して正常に読み込まれると、アクセスアドレス http://192.168.8.111:8003 が表示されます。
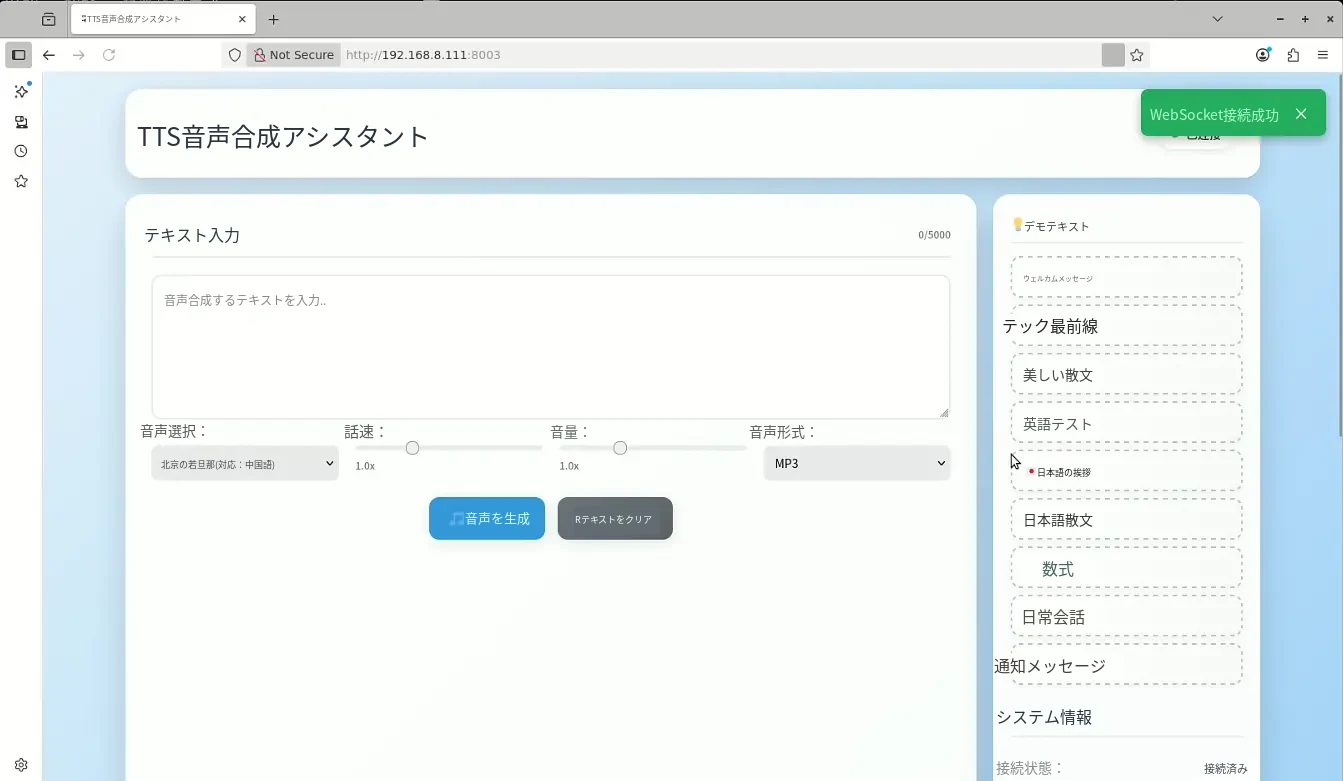
アドレスをクリックするか、ブラウザにコピーするとメイン画面が表示されます。中国語、英語、日本語などの音声合成を行うことができます。
- 「優美な散文」をクリックし、続いて「音声を生成」をクリックして合成を待ちます。

合成が終わると完全な音声が出力され、クリックして再生することも、ダウンロードすることもできます。
- 右側のメニューバーをクリックすると、英語や日本語なども合成できます。ぜひ試してみてください。
実験結果
テキストを中国語、英語、日本語など複数の言語の音声として出力し、音声をその場で再生することもダウンロードすることもできます。
情報交換・サポート
資料のダウンロード・技術サポートについては、HumansX株式会社までお問い合わせください。