 ドキュメント
視覚言語モデル VLM による画像解析
実験の目的
- VLM 視覚言語モデル (Vision Language Model) に基づき、画像理解と視覚解析を実現します。
応用シーン
VLM 視覚言語モデルシステムは、画像理解と視覚解析を必要とするインテリジェントなアプリケーションに適しており、画像キャプション生成、物体検出、視覚的質問応答、文字認識をインテリジェントに実現します。
主にインテリジェントロボットシステムにおける視覚認識タスクに使用され、自然言語の指示によって画像内容を解析し、物体の位置を検出し、視覚に関する質問に答え、文字情報を抽出します。インテリジェント監視、視覚ナビゲーション、文書処理、教育支援など、コンピュータビジョン能力を必要とする応用分野に適しています。
機能要件
画像に対して、画像キャプション生成、物体検出、視覚的質問応答、文字認識をインテリジェントに行います。たとえば猫の画像をアップロードすると、画像が伝えようとしている情報を解析して出力します。
- 画像解析機能:画像内容の詳細な説明と理解を提供
- 物体検出機能:画像内の物体を検出し、座標情報を提供
- 視覚的質問応答機能:画像内容に関する具体的な質問に回答
- 文字認識機能:画像内の文字内容を抽出
ハードウェアの準備
| No. | 名称 | 数量 | 備考 |
|---|---|---|---|
| 1 | RDK X5 | 1 | 組み込みメインボード、32GB メモリカード付き。上位機システムを実行。 |
| 2 | カードリーダー | 1 | イメージシステムの書き込みに使用。 |
| 3 | USB カメラ | 1 | 画像の取得。 |
| 4 | 電源ケーブル | 1 | 給電。 |
| 5 | LAN ケーブル(各自用意) | 1 | ネットワーク接続。 |
| 6 | ディスプレイ(各自用意) | 1 | 操作用。 |
| 7 | キーボード・マウス(各自用意) | 1 | メインボードとの操作用。 |
回路接続
ハードウェアモジュール
1.1ハードウェアインターフェース で RDK X5 のインターフェースを簡単に確認できます
実機の配線
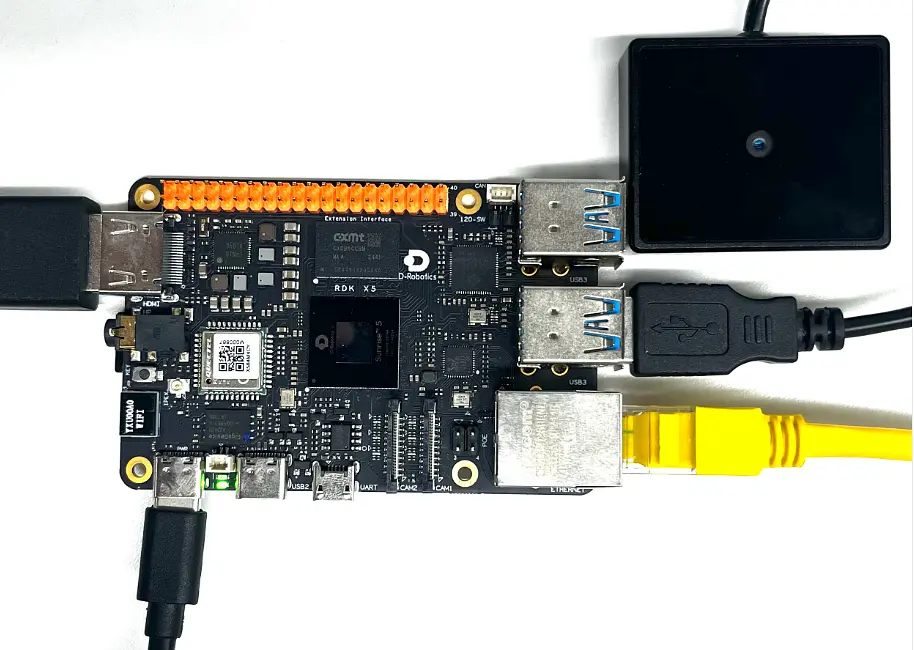
下図を参考に接続し、その後ディスプレイ、キーボード・マウスを接続します(またはリモートアクセスを行います)。
ソフトウェア設計
設計フローチャート
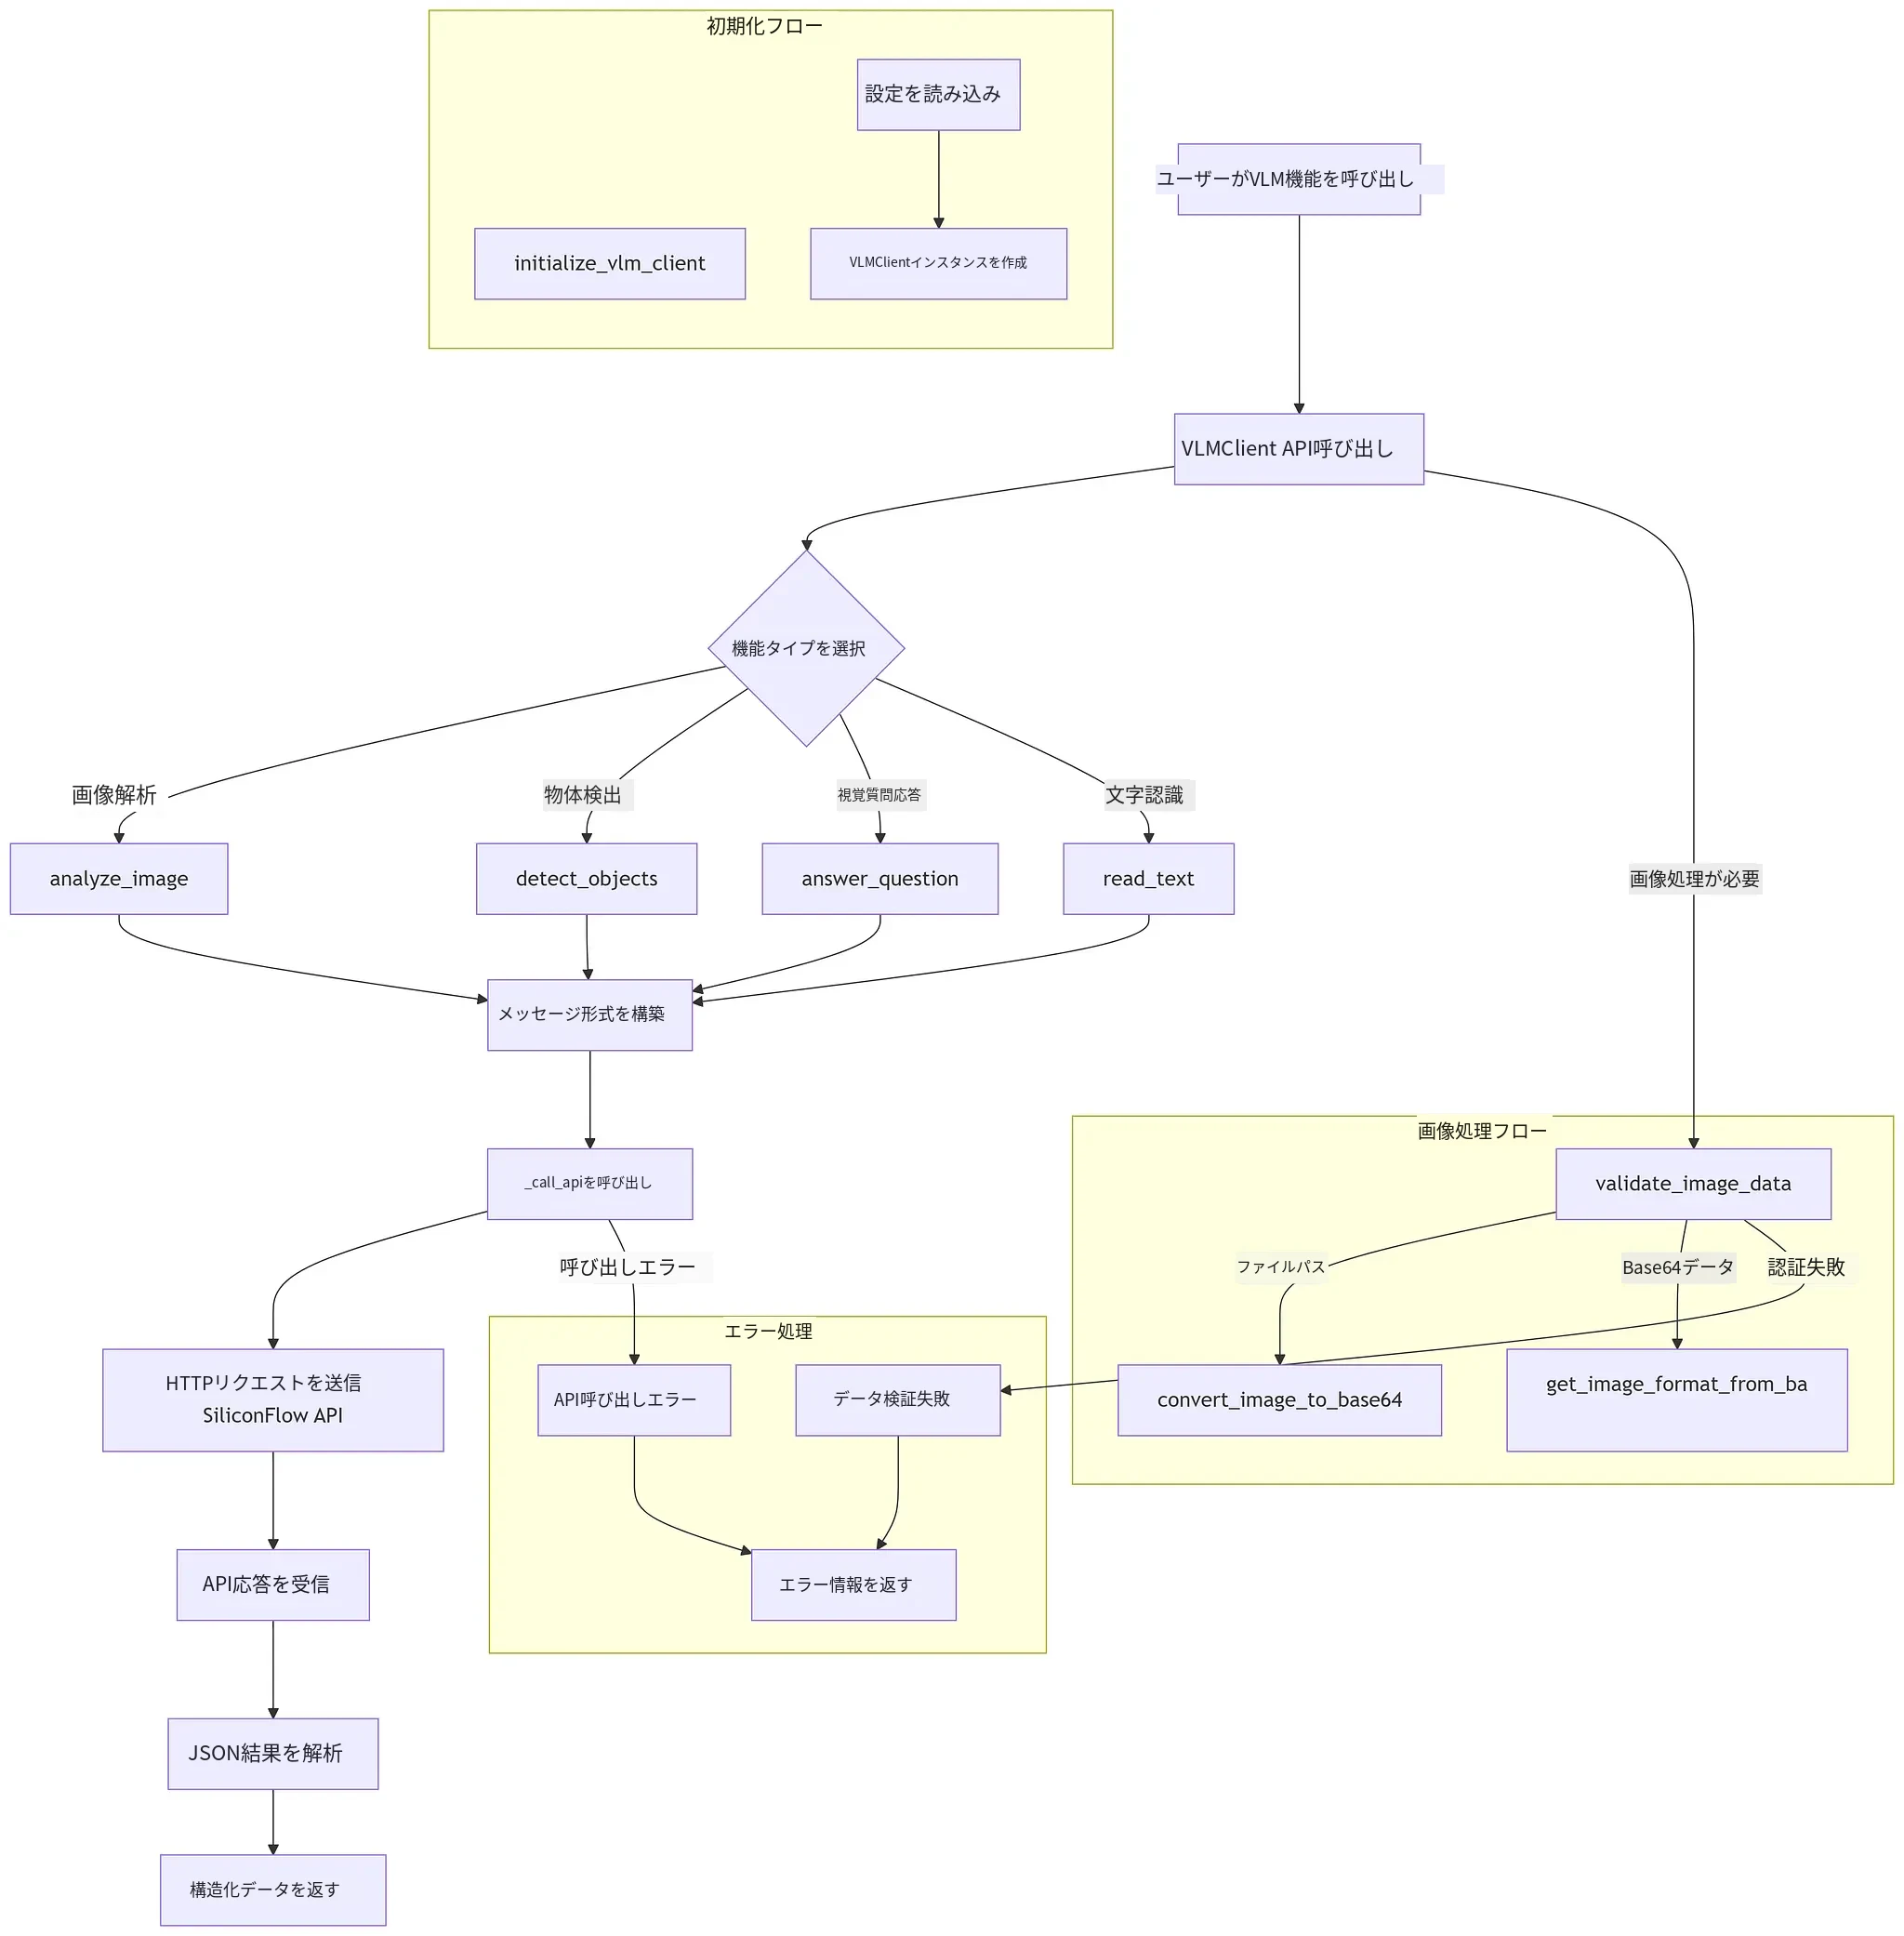
VLM インターフェースのフロー
VLM 実装のフロー
ソースコードのダウンロード
ソースコードファイル:llm.rar
(リンクをクリックしてオンラインの説明を見ることもできます)(HumansX サポートより提供)
プログラムコード
コードの構成:
| フォルダ | コード | 機能 |
|---|---|---|
| function_call | vlm_functions.py | LLM に視覚言語モデルの標準化された呼び出しインターフェースを提供し、画像解析・物体検出・視覚的質問応答・文字認識の 4 つのコア機能に対応 |
| vlm | | インターフェースを実装し、画像を解析 |
| _init.py | 公開インターフェースを定義し、コアクラスとユーティリティ関数をエクスポート | |
| image_utils.py | 画像の検証、形式変換、データ処理機能を提供 | |
| vlm_client.py | 画像解析・物体検出・視覚的質問応答・文字認識の 4 つのコア機能を提供 |
具体的なコード:
完全なプロジェクトコードは(ソースコードファイル)をクリックしてダウンロードしてください。
"""
VLM (Vision Language Model) 功能实现
提供图像理解和视觉分析的function-calling功能
"""

import base64
import logging
import os
import tempfile
from typing import Optional, Dict, Any
from pathlib import Path

from .function_registry import FunctionRegistry
from ..vlm.vlm_client import VLMClient
from ..vlm.image_utils import validate_image_data, convert_image_to_base64
from config.config_manager import get_config

logger = logging.getLogger(__name__)

# 全局VLM客户端实例
_vlm_client: Optional[VLMClient] = None

def initialize_vlm_client():
    """初始化VLM客户端"""
    global _vlm_client

    config = get_config()
    if not config.vlm.enabled:
        logger.info("VLM功能未启用")
        return

    if not config.vlm.api_key:
        logger.warning("VLM API密钥未配置,请在.env文件中设置SILICONFLOW_API_KEY")
        return

    try:
        _vlm_client = VLMClient(
            api_key=config.vlm.api_key,
            api_url=config.vlm.api_url,
            model_name=config.vlm.model_name,
            timeout=config.vlm.timeout
        )
        logger.info("VLM客户端初始化成功")
    except Exception as e:
        logger.error(f"VLM客户端初始化失败: {e}")
        _vlm_client = None

def get_vlm_client() -> Optional[VLMClient]:
    """获取VLM客户端实例"""
    return _vlm_client

@FunctionRegistry.register_function(
    'vlm_analyze_image',
    '分析图像内容,提供详细的图像描述和理解'
)
async def analyze_image(image_base64: str, prompt: str = "请详细描述这张图片的内容") -> Dict[str, Any]:
    """
    分析图像内容,提供详细的图像描述和理解

    Args:
        image_base64 (str): 图像的base64编码字符串
        prompt (str): 分析提示词,默认为"请详细描述这张图片的内容"

    Returns:
        Dict[str, Any]: 包含分析结果的字典
            - success (bool): 是否成功
            - description (str): 图像描述
            - details (dict): 详细分析结果
    """
    if not _vlm_client:
        return {
            "success": False,
            "error": "VLM客户端未初始化或配置不正确"
        }

    try:
        # 验证图像数据
        is_valid, error_msg = validate_image_data(image_base64)
        if not is_valid:
            return {
                "success": False,
                "error": f"图像数据验证失败: {error_msg}"
            }

        # 验证base64字符串
        if not image_base64.startswith('data:image/'):
            # 如果不是完整的data URL,尝试添加默认的PNG头部
            if not image_base64.startswith('iVBORw0KGgo') and not image_base64.startswith('/9j/'):
                image_base64 = f"data:image/png;base64,{image_base64}"

        result = await _vlm_client.analyze_image(image_base64, prompt)
        return {
            "success": True,
            "description": result.get("response", "未获得有效响应"),
            "details": result
        }
    except Exception as e:
        logger.error(f"图像分析失败: {e}")
        return {
            "success": False,
            "error": f"图像分析失败: {str(e)}"
        }

@FunctionRegistry.register_function(
    'vlm_detect_objects',
    '检测图像中的物体并提供边界框坐标'
)
async def detect_objects(image_base64: str, prompt: str = "请检测图像中的物体并提供边界框坐标") -> Dict[str, Any]:
    """
    检测图像中的物体并提供边界框坐标

    Args:
        image_base64 (str): 图像的base64编码字符串
        prompt (str): 检测提示词,默认为"请检测图像中的物体并提供边界框坐标"

    Returns:
        Dict[str, Any]: 包含检测结果的字典
            - success (bool): 是否成功
            - objects (list): 检测到的物体列表
            - coordinates (list): 边界框坐标列表
    """
    if not _vlm_client:
        return {
            "success": False,
            "error": "VLM客户端未初始化或配置不正确"
        }

    try:
        # 验证图像数据
        is_valid, error_msg = validate_image_data(image_base64)
        if not is_valid:
            return {
                "success": False,
                "error": f"图像数据验证失败: {error_msg}"
            }

        # 验证base64字符串
        if not image_base64.startswith('data:image/'):
            # 如果不是完整的data URL,尝试添加默认的PNG头部
            if not image_base64.startswith('iVBORw0KGgo') and not image_base64.startswith('/9j/'):
                image_base64 = f"data:image/png;base64,{image_base64}"

        result = await _vlm_client.detect_objects(image_base64, prompt)
        return {
            "success": True,
            "objects": result.get("objects", []),
            "coordinates": result.get("coordinates", []),
            "details": result
        }
    except Exception as e:
        logger.error(f"物体检测失败: {e}")
        return {
            "success": False,
            "error": f"物体检测失败: {str(e)}"
        }

@FunctionRegistry.register_function(
    'vlm_answer_visual_question',
    '回答关于图像内容的具体问题'
)
async def answer_visual_question(image_base64: str, question: str) -> Dict[str, Any]:
    """
    回答关于图像内容的具体问题

    Args:
        image_base64 (str): 图像的base64编码字符串
        question (str): 关于图像的问题

    Returns:
        Dict[str, Any]: 包含回答结果的字典
            - success (bool): 是否成功
            - answer (str): 问题的答案
    """
    if not _vlm_client:
        return {
            "success": False,
            "error": "VLM客户端未初始化或配置不正确"
        }

    try:
        # 验证图像数据
        is_valid, error_msg = validate_image_data(image_base64)
        if not is_valid:
            return {
                "success": False,
                "error": f"图像数据验证失败: {error_msg}"
            }

        # 验证base64字符串
        if not image_base64.startswith('data:image/'):
            # 如果不是完整的data URL,尝试添加默认的PNG头部
            if not image_base64.startswith('iVBORw0KGgo') and not image_base64.startswith('/9j/'):
                image_base64 = f"data:image/png;base64,{image_base64}"

        result = await _vlm_client.answer_question(image_base64, question)
        return {
            "success": True,
            "answer": result.get("response", "未获得有效响应"),
            "details": result
        }
    except Exception as e:
        logger.error(f"视觉问答失败: {e}")
        return {
            "success": False,
            "error": f"视觉问答失败: {str(e)}"
        }

@FunctionRegistry.register_function(
    'vlm_read_text',
    '识别并提取图像中的文字内容'
)
async def read_text(image_base64: str) -> Dict[str, Any]:
    """
    识别并提取图像中的文字内容

    Args:
        image_base64 (str): 图像的base64编码字符串

    Returns:
        Dict[str, Any]: 包含文字识别结果的字典
            - success (bool): 是否成功
            - text (str): 识别出的文字内容
    """
    if not _vlm_client:
        return {
            "success": False,
            "error": "VLM客户端未初始化或配置不正确"
        }

    try:
        # 验证图像数据
        is_valid, error_msg = validate_image_data(image_base64)
        if not is_valid:
            return {
                "success": False,
                "error": f"图像数据验证失败: {error_msg}"
            }

        # 验证base64字符串
        if not image_base64.startswith('data:image/'):
            # 如果不是完整的data URL,尝试添加默认的PNG头部
            if not image_base64.startswith('iVBORw0KGgo') and not image_base64.startswith('/9j/'):
                image_base64 = f"data:image/png;base64,{image_base64}"

        result = await _vlm_client.read_text(image_base64)
        return {
            "success": True,
            "text": result.get("response", "未获得有效响应"),
            "details": result
        }
    except Exception as e:
        logger.error(f"文字识别失败: {e}")
        return {
            "success": False,
            "error": f"文字识别失败: {str(e)}"
        }
操作手順
回路接続が完了したら:
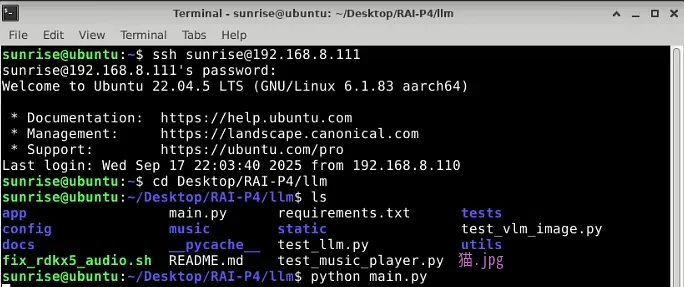
- ターミナルにリモートアクセスします。ターミナルで次のコマンドを入力し、Enter キーを押します
ssh sunrise@192.168.8.111
- サービスを起動します。llm フォルダに移動し、メインプログラム python main.py を起動します。
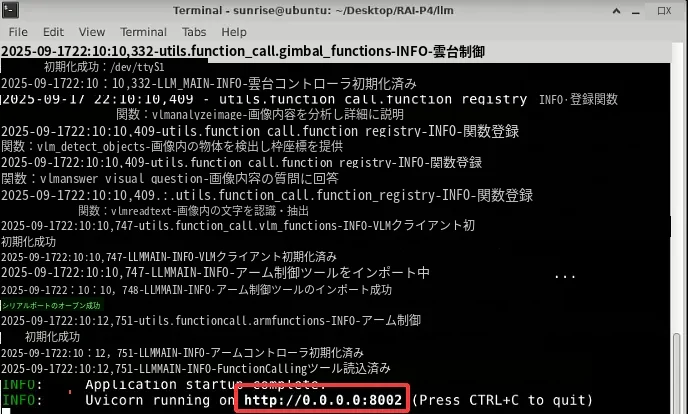
Enter キーを押して起動を待ちます。下の画面が表示されたら、http://0.0.0.0:8002 を開けることが示されます。
- ブラウザを開き、URL http://0.0.0.0:8002 を入力してアクセスします。起動後、LLM インテリジェント対話アシスタントのメイン画面が表示されます。
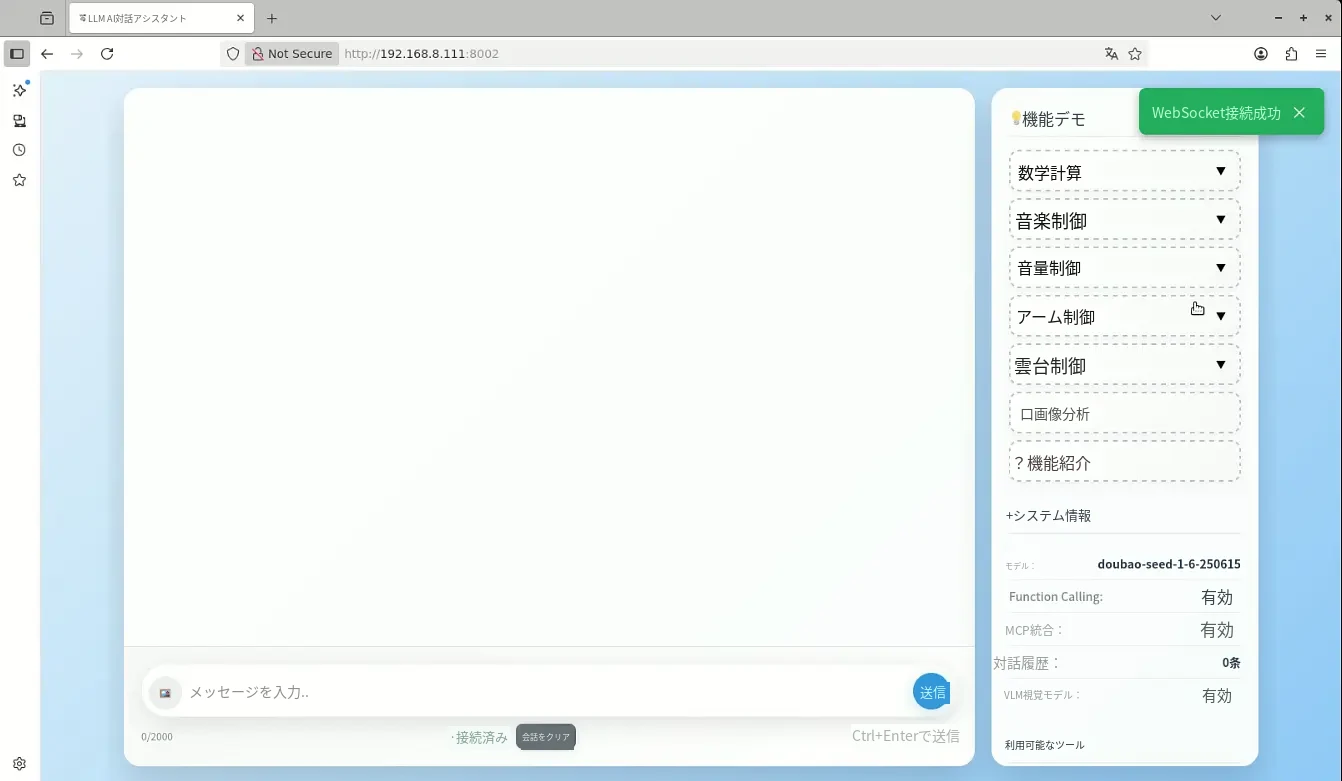
- 「画像解析」をクリックして解析結果を確認します。たとえば猫の画像をアップロードして、解析結果を確認します。

実験結果
アップロードした画像に対して画像理解と視覚解析を行い、結果を表示します。
コミュニティ
資料のダウンロード・技術サポートについては、HumansX株式会社までお問い合わせください。