 ドキュメント
音声テキスト変換 ASR -- 全体紹介(通義千問)
-
sherpa-onnx 音声認識エンジンとその特長を理解し、複数のモデルに対応して多言語を認識できるようにします。
-
自動音声認識(ASR)で sherpa-onnx モデルを呼び出す方法を理解します。
-
Models のモデルを読み込み、自動音声認識(ASR)の基本的な応用ができるようにします。
-
ASR 音声認識のデプロイ方法を習得します。
技術ポイント
- 音声処理: サンプリングレート、チャンネル、音声フォーマット変換を理解します
- リアルタイム通信: WebSocket の使い方を学びます
- ファイルアップロード: multipart/form-data 形式を理解します
- 非同期プログラミング: Python asyncio の使い方を体験します
- Web 開発: FastAPI フレームワークの基本的な使い方
応用シーン
音声コマンドの認識、会議の議事録作成、音声入力など。
機能要件
機能 1:音声ファイルをテキストに変換して出力します。
機能 2:マイクの音声をリアルタイムに取得し、テキストに変換して出力します。
システムアーキテクチャ
概要
ASR(自動音声認識)モジュールは FastAPI ベースの Web アプリケーションで、音声ファイルのテキスト変換とマイクからのリアルタイム認識機能を提供します。本モジュールは音声認識のコアエンジンとして sherpa-onnx を使用し、中国語の音声認識に対応しています。
アーキテクチャ設計
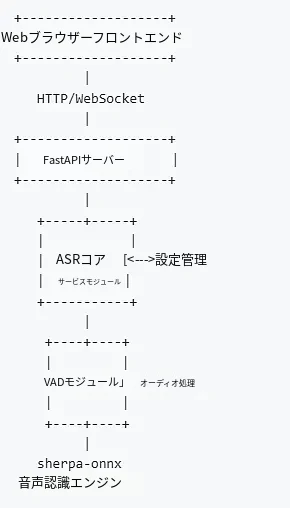
データフロー
音声ファイル認識の流れ
- ユーザーが Web 画面から音声ファイルをアップロードします
- FastAPI がファイルを受け取り、ASR サービスに渡します
- ASR サービスが音声フォーマットの検出と変換を行います
- soundfile/pydub で音声フォーマットを解析します
- 音声を 16kHz にリサンプリングします(モデルの要件)
- sherpa-onnx を呼び出して音声認識を行います
- 認識結果をフロントエンドに返します
マイクからのリアルタイム認識の流れ
- ユーザーが「リアルタイム認識開始」ボタンをクリックします
- ブラウザが WebSocket でサーバーに接続します
- ASR サービスが音声ストリームの監視(sounddevice)を開始します
- リアルタイムの音声データを VAD(sherpa-onnx VAD)で処理します
- 音声区間を sherpa-onnx ASR モデルに送って認識します
- 認識結果を WebSocket でリアルタイムにプッシュします
- フロントエンドの JavaScript が結果を受信して表示します
ASR 音声認識のデプロイ
コア機能
- 音声ファイルのテキスト変換: 音声ファイルをアップロードすると自動的にテキストに変換します
- マイクからのリアルタイム認識: マイクをリアルタイムで監視し、音声をテキストに変換します
特長
- シンプルで使いやすい: Web 画面を備え、複雑な設定は不要です
- 高精度な認識: sherpa-onnx の Paraformer 中国語音声認識モデルを利用しています
- リアルタイム体験: WebSocket で認識結果をリアルタイムにプッシュします
- クロスプラットフォーム: Windows、Linux、macOS に対応しています
クイックデプロイ
1. 動作環境
- Python 3.8+
- オーディオデバイスに対応したシステム(Linux)
2. モデルファイルのダウンロード
ASR モジュールを正常に動作させるには、特定のモデルファイルが必要です。次の手順に従ってください:
# 下载模型文件
# 通过百度网盘下载:models.zip
# 提取码: dab2
#
# 下载后,将zip文件解压到asr/目录中
# 确保解压后的模型文件位于: asr/models/ 目录下
3. 依存関係のインストール
cd asr
pip install -r requirements.txt
4. システム依存関係(Linux)
ASR モジュールは、音声の録音と処理に ALSA オーディオシステムを使用します。お使いのシステムに応じて必要な依存関係をインストールしてください:
# Ubuntu/Debian
sudo apt-get install libasound2-dev portaudio19-dev

# CentOS/RHEL
sudo yum install alsa-lib-devel portaudio-devel

# 检查音频设备
arecord -l  # 查看可用的录音设备
aplay -l   # 查看可用的播放设备
注意:
- システムに使用可能な音声入力デバイス(マイク)があることを確認してください
- オーディオデバイスの権限の問題がある場合は、ユーザーを audio グループに追加する必要があることがあります:
sudo usermod -a -G audio $USER
5. アプリケーションの起動
python main.py
6. アプリケーションへのアクセス
ブラウザで次のアドレスにアクセスしてください: http://localhost:8001
詳細ドキュメント
詳細については、以下のドキュメントをご覧ください:
音声テキスト変換 ASR – アーキテクチャ設計
音声テキスト変換 ASR – API インターフェース説明
音声テキスト変換 ASR – sherpa-onnx 認識フレームワークの紹介
音声テキスト変換 ASR – 設定説明
パラメータを理解し、二次開発やデバッグに活用できます。
sherpa-onnx 公式ドキュメント
上記の事例ではそのうちの 1 つのモデルのみを使用していますが、公式には対応済みのモデルが他にも多数あります。必要に応じてモデルを選択してください。
公式リポジトリ:
https://github.com/k2-fsa/sherpa-onnx
公式ドキュメント:
https://k2-fsa.github.io/sherpa/onnx/
デプロイの実装
音声テキスト変換 ASR システムの実装
情報交換・サポート
資料のダウンロード・技術サポートについては、HumansX株式会社までお問い合わせください。